Services: Summarization und Compliance
Im Projekt unterstützt DFKI die Entwicklung von KI-Anwendungen für den journalistischen Einsatz und untersucht zugleich, wie deren Qualität und Zuverlässigkeit systematisch überprüft werden können. Im Mittelpunkt stehen dabei insbesondere Validierung und Evaluation, Transparenz und Erklärbarkeit sowie die Analyse typischer Fehler und Grenzen generativer KI. Diese Arbeiten werden sowohl in eigenen Forschungsansätzen als auch gemeinsam mit den Projektpartnern in konkreten Anwendungen umgesetzt, etwa bei der automatischen Zusammenfassung journalistischer Texte und der Prüfung auf die Einhaltung journalistischer Standards.
Automatische Zusamenfassungen: Präzise Längensteuerung mit Diffusions-Sprachmodellen
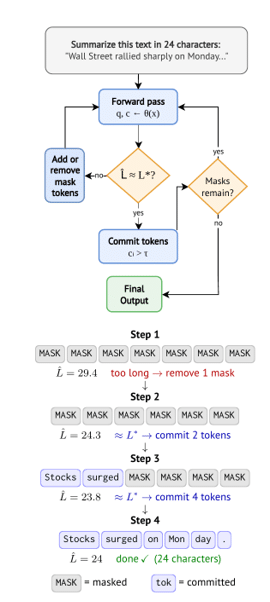
Im Bereich der automatischen Textzusammenfassung untersucht DFKI neue Verfahren, mit denen sich Zusammenfassungen nicht nur inhaltlich hochwertig, sondern auch mit einer sehr präzise vorgegebenen Länge erzeugen lassen. Eine solche Längensteuerung ist beispielsweise für Überschriften, Vorschautexte, Push-Nachrichten oder andere Formate relevant, bei denen nur eine begrenzte Anzahl von Zeichen zur Verfügung steht. Herkömmliche autoregressive Sprachmodelle können solche Zeichenbudgets häufig nur näherungsweise einhalten, da sie Text schrittweise von links nach rechts erzeugen und bereits generierte Passagen während der Generierung nicht mehr verändern können.
Ein aktueller Forschungsansatz nutzt deshalb Diffusions-Sprachmodelle, die den Text nicht sequenziell erzeugen, sondern eine zunächst maskierte Ausgabe schrittweise vervollständigen. Mit dem Verfahren DELTA (Diffusion Expected Length Targeting Algorithm) wird während dieses Prozesses fortlaufend die zu erwartende Zeichenlänge geschätzt. Ist die Ausgabe voraussichtlich zu lang oder zu kurz, können noch nicht festgelegte Positionen entfernt beziehungsweise hinzugefügt werden. Auf diese Weise lässt sich die Länge bereits während der Generierung korrigieren. DELTA ist ein trainingsfreier Ansatz und benötigt weder ein zusätzliches Fine-Tuning noch Änderungen an der Modellarchitektur.
Die Evaluation mit den Diffusionsmodellen LLaDA und Dream auf drei unterschiedlichen Summarization-Benchmarks zeigt eine sehr hohe Genauigkeit der Längensteuerung. Der durchschnittliche Fehler liegt je nach Datensatz und Modell nur zwischen 2,3 und 3,1 Zeichen; mehr als 98 % der erzeugten Zusammenfassungen liegen innerhalb von zehn Zeichen um die vorgegebene Ziellänge. Gleichzeitig bleibt die inhaltliche Qualität der Zusammenfassungen bei etablierten automatischen Metriken wie ROUGE und BERTScore konkurrenzfähig. Damit zeigt der Ansatz ein besonderes Potenzial für Anwendungen, bei denen Textqualität und strikte formale Vorgaben gleichzeitig erfüllt werden müssen.
Aktuelle Forschungsfragen betreffen unter anderem die noch vergleichsweise hohe Rechenzeit von Diffusions-Sprachmodellen, die weitere Verbesserung der Textqualität sowie die Übertragung des Ansatzes auf andere Sprachen und weitere Formen kontrollierter Textgenerierung.
Automatische Zusammenfassungen: Evaluierung im Redaktionstool
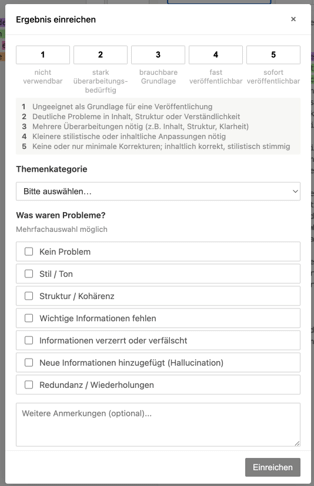
3pc entwickelte ein KI-basiertes Redaktionstool zur Kürzung journalistischer Texte. DFKI unterstützt die Entwicklung durch Beratung zum Einsatz generativer KI mit dem Ziel, die Qualität der erzeugten Textfassungen zu verbessern, unter anderem durch gezieltes Prompt Engineering. Darüber hinaus konzipierte DFKI eine direkt in das Tool integrierte Evaluierung, um die LLM-Ausgaben unter realen redaktionellen Arbeitsbedingungen zu untersuchen.
Redakteur:innen bewerten die generierten Texte hinsichtlich ihrer Veröffentlichbarkeit auf einer fünfstufigen Skala und markieren konkrete Probleme, etwa bei Stil und Ton, Struktur und Kohärenz, fehlenden wichtigen Informationen, inhaltlichen Verfälschungen, hinzugefügten Informationen sowie Redundanzen; zusätzlich können Freitextkommentare erfasst werden. Darüber hinaus werden Bearbeitungszeit, Ziel- und tatsächliche Textlänge sowie Ausgangstext, LLM-Fassung und final redigierte Version gespeichert. So lassen sich sowohl die wahrgenommene Qualität als auch der tatsächliche redaktionelle Nachbearbeitungsaufwand und typische Editiermuster analysieren.
Das Redaktionstool ist seit Juli bei dpa im Einsatz und wird von den beteiligten Redakteur:innen positiv aufgenommen. Die bisherigen Ergebnisse sind sehr vielversprechend: Die automatisch erzeugten Textfassungen erreichen im Durchschnitt 4,4 von 5 Punkten hinsichtlich ihrer Veröffentlichbarkeit; mehr als die Hälfte der Texte wurde sogar als sofort veröffentlichbar bewertet. Wenn Probleme auftreten, betreffen sie vor allem fehlende oder nicht optimal gewichtete wichtige Informationen; Struktur- oder Redundanzprobleme sind deutlich seltener. Besonders zeitsparend sei das Tool bei der Zusammenfassung von kürzeren Texten. Auch die Einhaltung der vorgegebenen Textlänge funktioniert sehr zuverlässig: 98 % der Ausgaben liegen innerhalb der definierten Toleranzgrenze von 100 Zeichen. Der Test wird kontinuierlich fortgeführt und soll in Kürze auf mehr Editoren und weitere Modelle neben Claude Sonnet ausgeweitet werden. Ergänzend ist eine Studie geplant, die erfassen soll, wie gut sich das Tool in den redaktionellen Arbeitsablauf integrieren lässt und wie die Redakteur:innen ihre Handhabung und den praktischen Nutzen bewerten. Die dabei identifizierten Verbesserungspotenziale sollen unmittelbar in die Weiterentwicklung des Redaktionstools einfließen. Dazu gehören beispielsweise eine tiefere Integration in bestehende redaktionelle Workflows, die Anbindung an Layoutvorlagen sowie weitere Verbesserungen bei der Kürzung sehr langer Texte.
Automatisches Prüfen der Einhaltung von journalistischen Standards
Journalistische Selbstregulierung basiert auf Pressekodizes, die unter anderem Standards zu Sorgfalt, Diskriminierung, Persönlichkeitsrechten und der Trennung von Werbung und Redaktion festlegen. Die Prüfung, ob ein journalistischer Beitrag diese Regeln einhält, ist anspruchsvoll: Abstrakte Normen müssen auf konkrete Veröffentlichungen angewendet und mögliche Verstöße nachvollziehbar begründet werden.
Im Projekt untersucht DFKI, wie Large Language Models Compliance-Prüfungen journalistischer Inhalte unterstützen können, wie zuverlässig sie dabei arbeiten und in welchen Bereichen noch Probleme auftreten. Grundlage bilden veröffentlichte Entscheidungen des Deutschen Presserats, die wir mit den beanstandeten Artikeln zu einem Testdatensatz verknüpfen. Aus den Entscheidungen extrahieren wir Beschwerde, Stellungnahme, Begründung, Ergebnis und weitere Metadaten, die sowohl der Evaluation als auch der Analyse möglicher Ursachen von Fehlbewertungen dienen. DFKI hat eine LLM-basierte Pipeline implementiert, die verschiedene Anwendungsszenarien abbildet: Das Modell bewertet ausschließlich den Artikel, erhält zusätzlich die Beschwerde und Stellungnahme oder nutzt alle verfügbaren Informationen gemeinsam. Dabei soll es erkennen, welche Regeln des Pressekodex verletzt wurden, die Schwere des Verstoßes einschätzen und eine nachvollziehbare Begründung erzeugen. Solche Bewertungen können sowohl Prüfstellen bei der Bearbeitung von Beschwerden als auch Redaktionen dabei unterstützen, mögliche Verstöße bereits vor der Veröffentlichung zu erkennen – auch bei KI-generierten Inhalten. Ergänzend zum Demonstrator von Condat hat DFKI einen weiteren Demonstrator zur automatisierten Compliance-Prüfung und zur Visualisierung der Evaluationsergebnisse entwickelt.
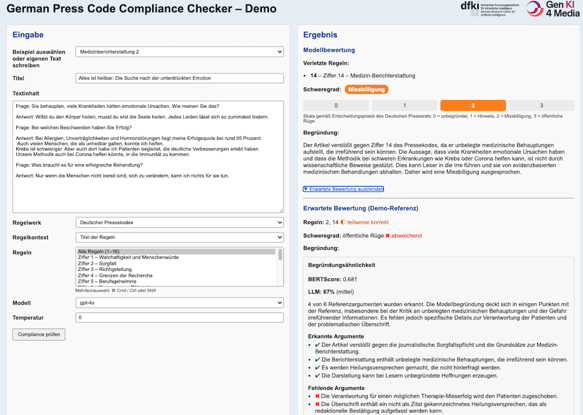
Die bisherigen Ergebnisse zeigen, dass zusätzlicher Kontext die Bewertung deutlich verbessert. Informationen aus Beschwerde und Stellungnahme helfen dabei, relevante Verstöße und Argumente zu identifizieren. Gleichzeitig zeigt sich eine Tendenz, eher einen Verstoß anzunehmen als einen Beitrag als unproblematisch einzustufen. Zudem scheint es für LLMs noch schwierig zu sein, allgemeine gesellschaftliche oder intuitive Normvorstellungen von den spezifischen professionellen Standards des Journalismus zu unterscheiden. Besonders anspruchsvoll ist deshalb die Bewertung allein auf Grundlage eines Artikels. Hier fehlen nicht nur Hinweise aus einer Beschwerde auf möglicherweise problematische Aspekte; teilweise ist auch allgemeines, aktuelles oder fachliches Hintergrundwissen notwendig. Gerade dieses Szenario ist jedoch für eine Prüfung vor der Veröffentlichung besonders relevant. Auch die Qualität der generierten Begründungen wird untersucht. Dazu vergleichen wir die vom Modell genannten Argumente mit den Argumenten in den Entscheidungen des Presserats. Insgesamt zeigen die Ergebnisse, dass auch große kommerzielle Modelle mit einfachen, allgemein gehaltenen Ansätzen bislang nur begrenzt zuverlässig arbeiten. Insbesondere die Erkennung komplexerer und feingranularer Verstöße sowie stark kontext- und wissensabhängige Bewertungen stellen weiterhin eine Herausforderung dar. Zusätzliche regel- oder fallspezifische Informationen sowie stärker spezialisierte Verfahren könnten hier zu Verbesserungen beitragen.